Анатомия датасета RIAWELC. Полезный проект или псевдо-академическая стряпня?
В области неразрушающего контроля (NDT) и радиографии сварных соединений открытых качественных данных традиционно мало. Поэтому появление любой новой выборки привлекает внимание инженеров. В 2023 году вышла статья «RIAWELC: A Novel Dataset of Radiographic Images for Automatic Weld Defects Classification» [1], где авторы презентовали общедоступный датасет из 24 407 патчей рентгеновских снимков, заявив о сборе «сырых промышленных данных в реальном производстве» и точности классификации свёрточной сетью свыше 93%.
Однако при детальном инженерном аудите выясняется занятная картина. Во-первых, «новый» датасет собран из давно известной базы GDXray [2]. Во-вторых — и это куда опаснее для практики — даже если закрыть глаза на происхождение снимков, сам датасет сформирован с фундаментальными методологическими ошибками, делающими заявленную точность красивой иллюзией. Разберёмся, что пошло не так.
1. Генезис данных: знакомые всё лица
В преамбуле статьи [1] авторы справедливо сетуют, что знаменитый датасет GDXray (серия Welds) [2] содержит всего 68 снимков, чего для прямого обучения CNN мало. И тут же предлагают решение — собственный датасет RIAWELC, якобы снятый на производстве.
Но если взглянуть на образцы исходных данных в статье [1] и сопоставить их с классическим GDXray [2], дежавю наступает мгновенно:
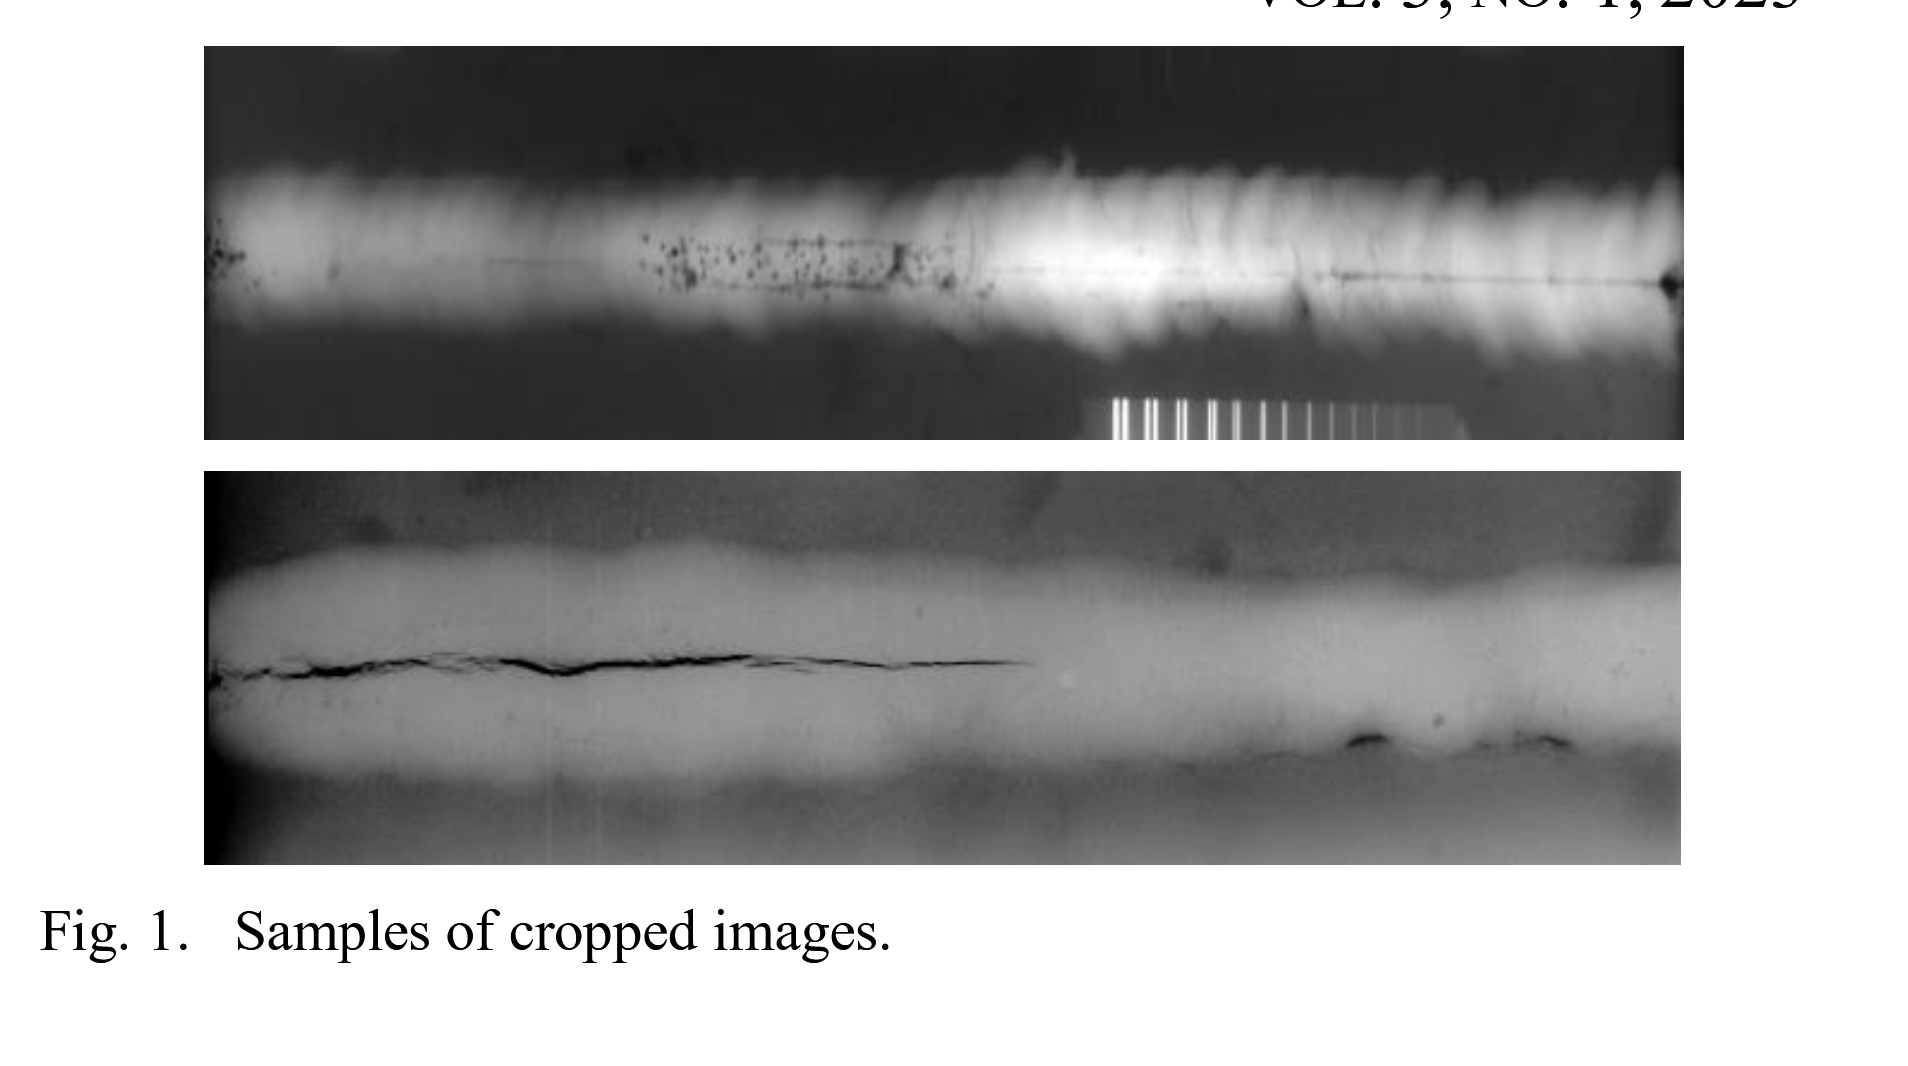
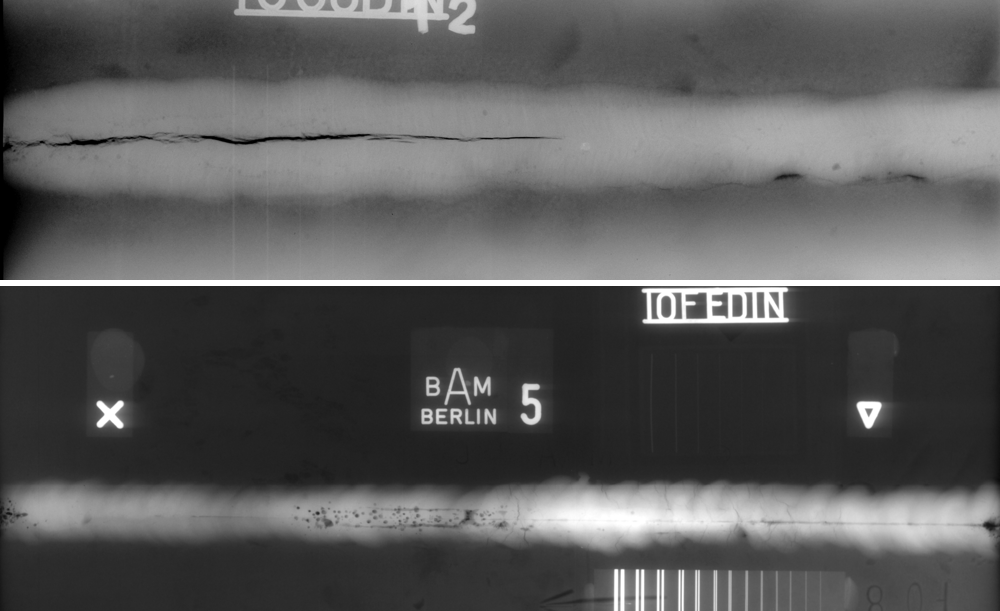
Характерные продольные трещины, скопления пор и даже тестовые гребёнки эталонов чувствительности BAM Berlin идентичны до пикселя. А открыв официальный GitHub-репозиторий проекта RIAWELC [1], мы видим прямые подтверждения:
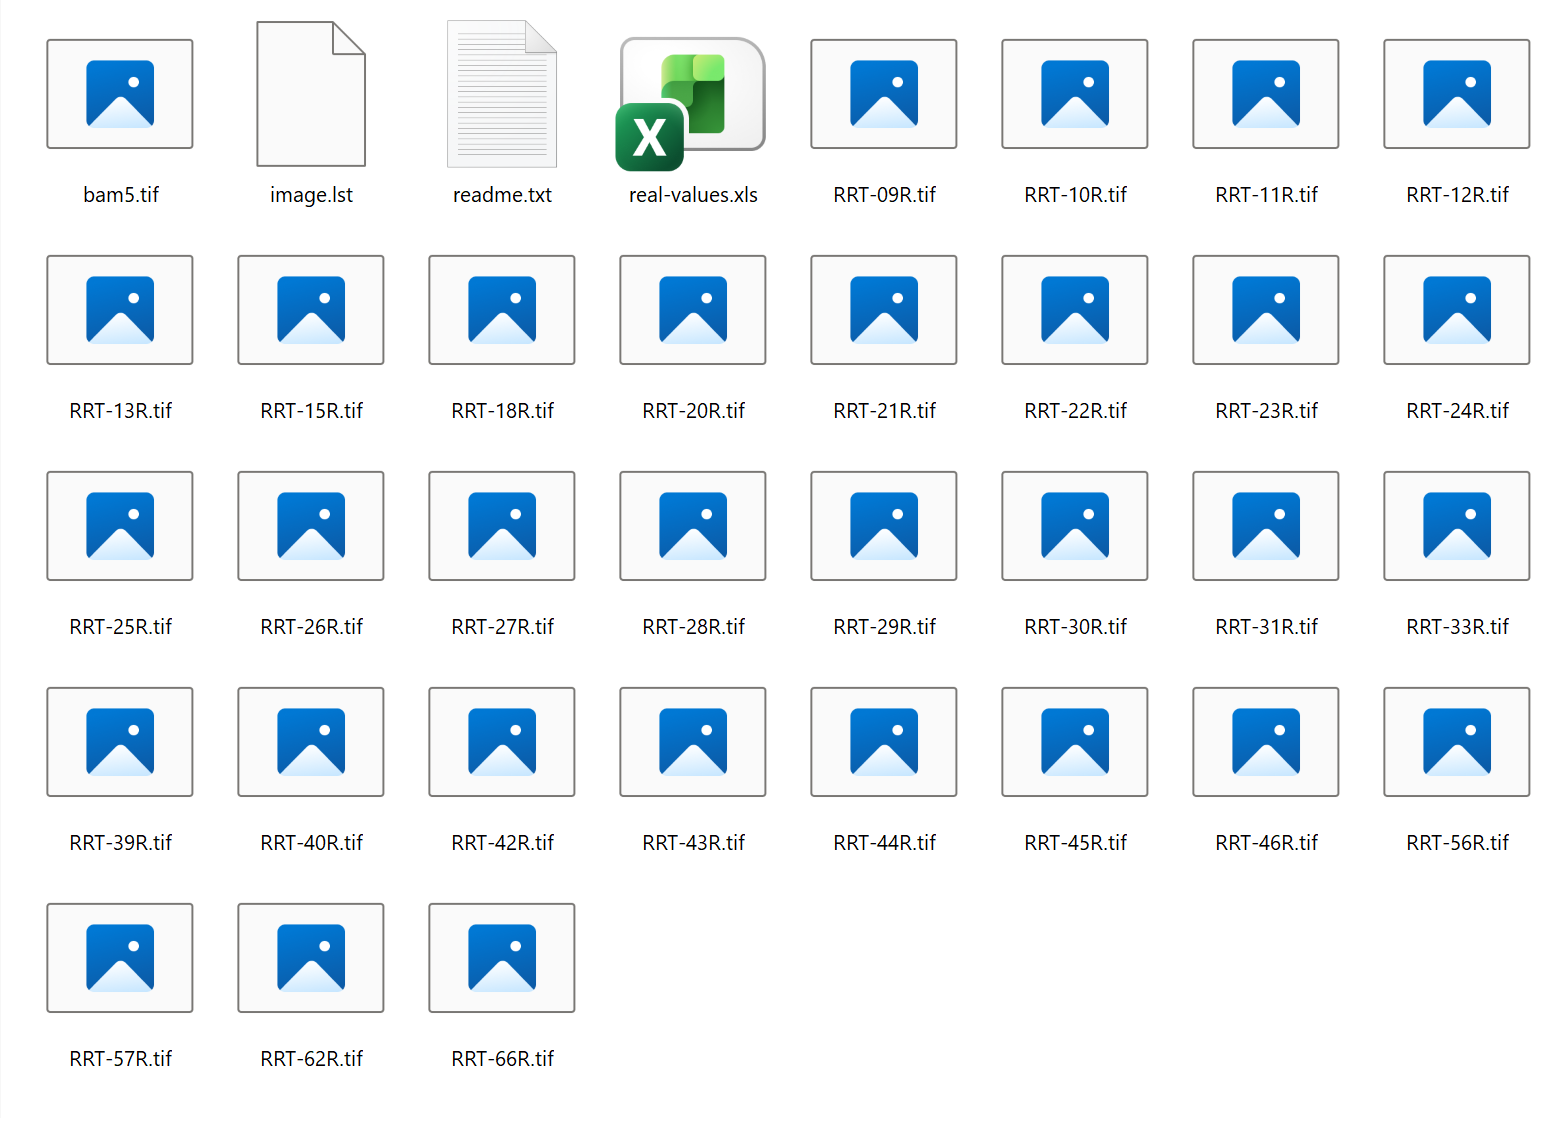
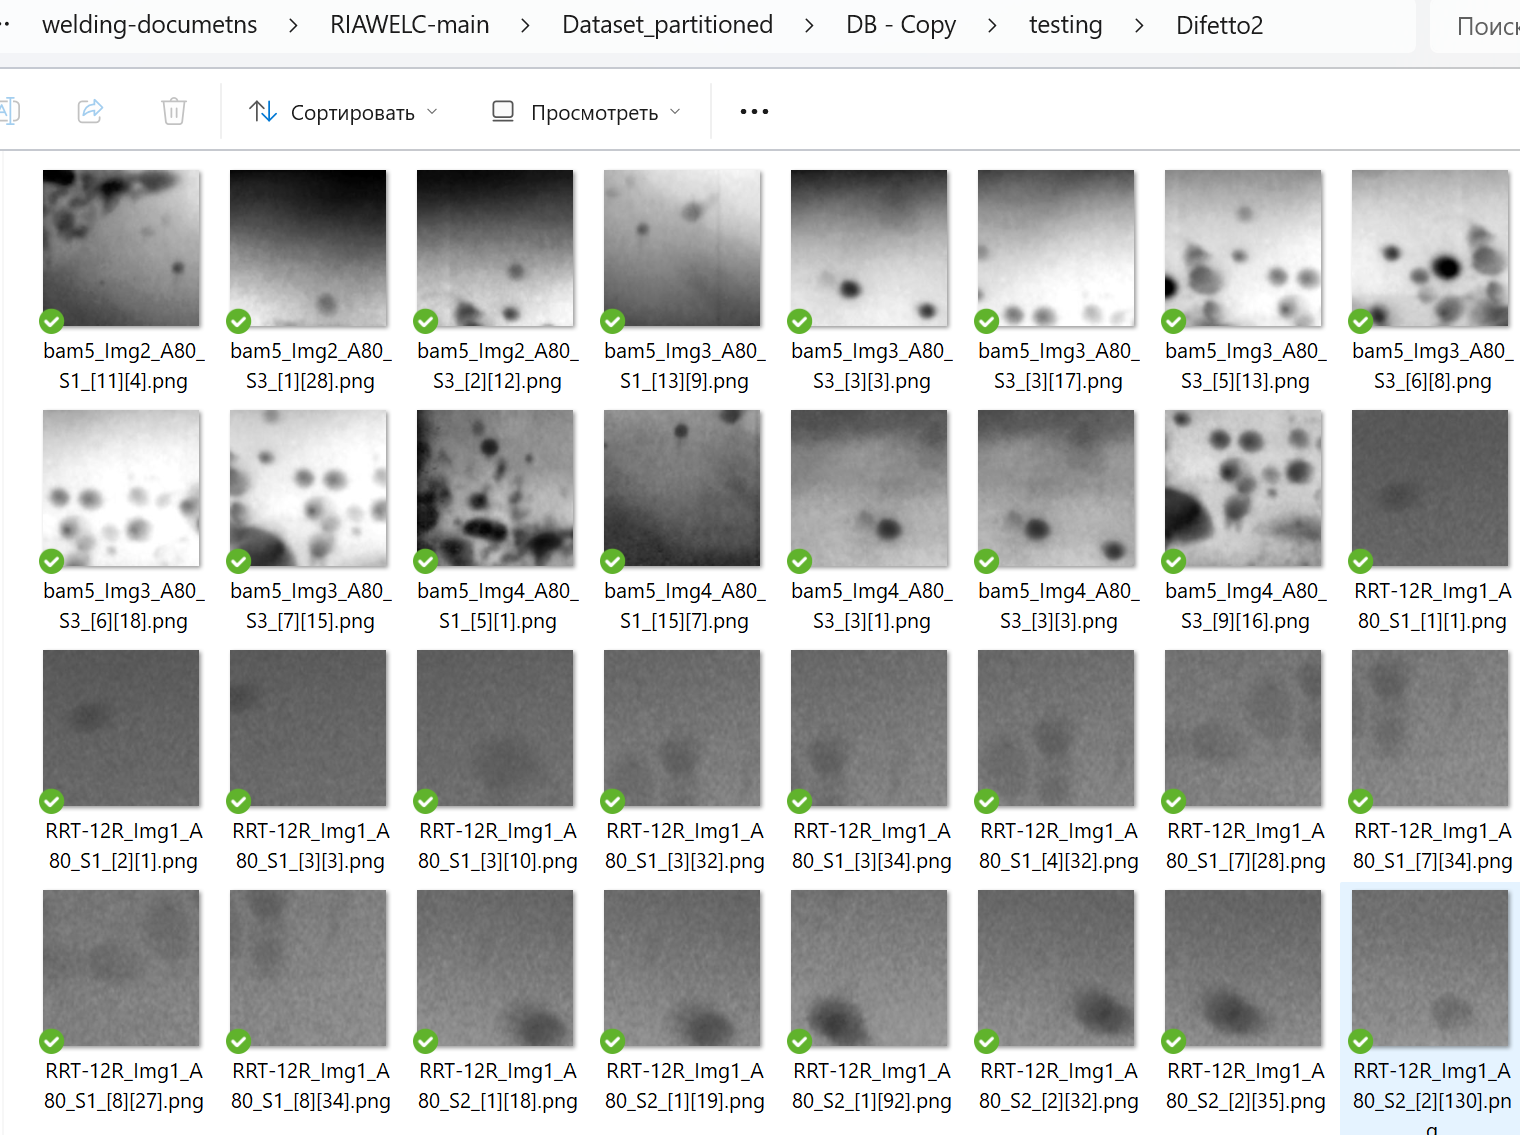
В именах файлов в RIAWELC фигурируют префиксы bam5_... и RRT-12R_...:
bam5_Img2_A80_S1_[11][4].png
RRT-12R_Img1_A80_S1_[3][32].png
RRT-12R_Img1_A80_S1_[3][34].png
В самой базе GDXray [2] серии сварных швов разбиты по папкам W0001, W0002, W0003, W0004, где файлы названы по шаблону W0003_0001.png ... W0003_0068.png. Однако прямо в папке W0003 лежит служебный файл W0003_readme.txt, документирующий соответствие:
The TIFF files were converted to PNG format as follows (2015/Feb/11)

W0003_0001.png is RRT-09R.tif
W0003_0002.png is RRT-101R.tif
W0003_0003.png is RRT-102R.tif
W0003_0004.png is RRT-104R.tif
W0003_0005.png is RRT-105R.tif
W0003_0006.png is RRT-106R.tif
W0003_0007.png is RRT-107R.tif
W0003_0008.png is RRT-108R.tif
W0003_0009.png is RRT-10R.tif
W0003_0010.png is RRT-11R.tif
W0003_0011.png is RRT-12R.tif
W0003_0012.png is RRT-13R.tif
...
W0003_0066.png is RRT-98R.tif
W0003_0067.png is RRT-99R.tif
W0003_0068.png is bam5.tif
Благодаря этой таблице сопоставление закрывается на 100%: W0003_0011.png — это RRT-12R.tif, а W0003_0068.png — это bam5.tif. Авторы RIAWELC [1] взяли исходные TIFF-файлы GDXray [2] и нарезали их скользящим окном 80×80 (суффикс A80), просто сохранив имя исходника и приписав координаты сетки [row][col].
Впрочем, если бы исследователи честно заявили: «Мы сделали удобную стандартизированную нарезку на базе GDXray для бенчмаркинга классификаторов» — сообщество сказало бы искреннее спасибо. Проблема заключается в том, как именно эти данные были нарезаны и поделены.
2. Почему этот датасет непригоден: 3 критические ошибки
Ошибка 1. Фатальная утечка данных (Spatial Data Leakage)
В оригинальной серии Welds базы GDXray [2] всего 68 длинных полос. Каким образом из 68 пластин авторы получили 24 407 патчей? Только одним: скользящее окно 80×80 двигали с колоссальным перекрытием.
Затем авторы сложили все 24 тысячи нарезанных картинок в общий пул и выполнили случайный сплит (Random Split) на Train (65%), Validation (25%) и Test (10%) [1].
В результате патч с координатами [3][32] попал в test, а соседние перекрывающиеся участки [3][31] и [3][33], сдвинутые на пару миллиметров и содержащие ту же самую пору или край трещины, ушли в train. Модель в тесте не ищет дефекты — она узнаёт текстуру конкретной пластины, которую видела в обучении. Отсюда и победные 93.3% accuracy, заявленные в статье [1], которые обнулятся на первом же независимом стыке с другого рентгеновского аппарата.
Ошибка 2. Потеря пространственного контекста (Окно 80×80)
Рентгенограмма сварного шва — это не снимок рукописной цифры. Окно 80×80 при исходном разрешении сканирования охватывает слишком узкую полоску. В него попадает либо кусок валика усиления, либо фрагмент трещины без краев. Сетка лишается пространственного контекста: она не видит околошовную зону, границы сплавления и разделку кромок, из-за чего отличить дефект провара от естественного перепада толщины металла становится лотереей.
Ошибка 3. Искусственный баланс классов без учёта топологии
На реальном снимке 90–95% площади шва — это норма (No Defect). Авторы нарезали дефектные участки с плотным шагом, искусственно раздув классы трещин и пор, а потом выровняли выборки в таблице датасета [1]. Модель привыкает к стерильному миру, где металл сплошь усеян дефектами, что гарантирует лавину ложных срабатываний (False Positives) на реальном производстве.
3. Как готовить NDT-датасет правильно
Единственный рабочий стандарт для промышленного контроля — Group Split (разбиение по физическим деталям):
- Изоляция источников: одна физическая деталь (исходный шов) целиком уходит либо в Train, либо в Test. Никаких общих стыков между выборками.
- Асимметричный шаг: плотный шаг с перекрытием допустим исключительно для Train как форма внутренней аугментации. Для Val/Test нарезка выполняется строго без перекрытия (шаг равен размеру окна), чтобы отражать объективную точность.
Пример корректного группового распределения исходных файлов GDXray [2] перед нарезкой на Python:
from pathlib import Path
import numpy as np
from sklearn.model_selection import GroupShuffleSplit

# Собираем список исходных рентгенограмм (целых пластин)
raw_plates = sorted(list(Path("./gdxray_welds").glob("*.tif")))
plate_ids = [p.stem.split("_")[0] for p in raw_plates]  # группировка по физической детали

# Честный сплит: одна деталь целиком уходит либо в train, либо в test
splitter = GroupShuffleSplit(n_splits=1, test_size=0.2, random_state=42)
train_idx, test_idx = next(splitter.split(raw_plates, groups=plate_ids))

train_plates = [raw_plates[i] for i in train_idx]
test_plates = [raw_plates[i] for i in test_idx]

print(f"Пластин на обучение: {len(train_plates)}, пластин на тест: {len(test_plates)}")
Выводы
Датасет RIAWELC [1] — показательный пример того, как погоня за красивыми метриками перечеркивает практическую ценность. Взять открытые снимки — нормальная практика, но заявить их как «собственные заводские данные», а затем допустить критическую утечку данных через случайный сплит оверлапов — методологический тупик.
Для реальных прикладных задач неразрушающего контроля этот датасет «как есть» использовать нельзя. Надежный путь — брать исходные TIFF-файлы GDXray [2], строить собственный пайплайн нарезки с физической изоляцией образцов и честно валидировать архитектуры.
Ссылки и источники
-
RIAWELC: A Novel Dataset of Radiographic Images for Automatic Weld Defects Classification
Benito Totino, Fanny Spagnolo, Stefania Perri
Dept. of Informatics, Modeling, Electronics and Systems Engineering, University of Calabria, Rende, Italy
Dept. of Mechanical, Energy and Management Engineering, University of Calabria, Rende, Italy
International Journal of Electrical and Computer Engineering Research (IJECER), Vol. 3, No. 1, pp. 13–17, 2023. DOI: 10.53375/ijecer.2023.320.
Репозиторий проекта: https://github.com/stefyste/RIAWELC
📄 Скачать статью: RIAWELC_A_Novel_Dataset_of_Radiographic_Images_for.pdf -
GDXray: The Database of X-ray Images for Nondestructive Testing
Domingo Mery, Vladimir Riffo, Uwe Zscherpel, German Mondragón, Iván Lillo, Irene Zuccar, Hans Lobel, Miguel Carrasco
Journal of Nondestructive Evaluation, Vol. 34, No. 4, Art. 42, 2015. DOI: 10.1007/s10921-015-0315-7.
Репозиторий проекта: https://github.com/computervision-xray-testing/GDXray
📄 Скачать статью: 2015_GDXray.pdf